

超高速ディープラーニングシステム「CS-4」
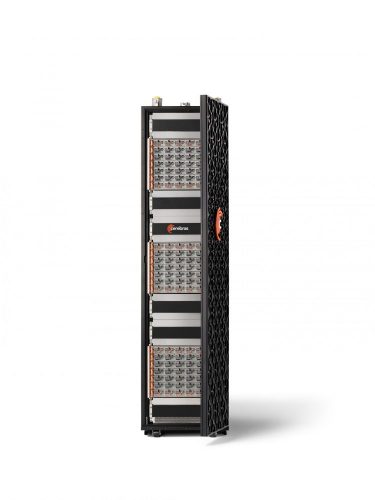
Cerebras | CS-4
Cerebras社のCS-4は、CS-1から続くCerebras第4世代の巨大半導体チップを実装したディープラーニング専用システムです。GPUベースの従来システムと比べて省スペース・低消費電力で超高速な学習処理を行うことが可能です。
ピンチアウトで拡大
「CS-4」には、ディープラーニング専用に設計された21.5cm角の大型半導体「ウェハースケールエンジン(WSE-3 Turbo)」を搭載しています。「WSE-3 Turbo」は積和演算を実行する90万個のコアと、効率的なデータアクセスのためにコア毎に高速なローカルメモリを実装し、コア間で非常に高速な通信が可能になるように設計されています。
| CS-1(WSE-1) | CS-2(WSE-2) | CS-3(WSE-3) | CS-4(WSE-3T) | |
| 製造プロセス | TSMC 16nm | TSMC 7nm | TSMC 5nm | TSMC 5nm |
| シリコン面積 | 46,225 ㎟ | 46,225 ㎟ | 46,225 ㎟ | 46,225 ㎟ |
| トランジスタ数 | 1.2 Trillion | 2.6 Trillion | 4 Trillion | 4 Trillion |
| 疎線形代数演算コア | 400,000 | 850,000 | 900,000 | 900,000 |
| オンチップSRAM | 18 GB | 40 GB | 44 GB | 44 GB |
| メモリ帯域 | 9 PB/s | 20 PB/s | 21 PB/s | 43.2 PB/s |
| コア間インターコネクト | 100 Pb/s | 220 Pb/s | 214 Pb/s | 428 Pb/s |
|
|
CS-3システム |
CS-4システム |
仕様比較 |
|
チップ数 |
1 WSE-3 |
3 WSE-3 Turbo |
3 倍 |
|
計算性能(FP16) |
125 PFLOPS |
750 PFLOPS |
6 倍 |
|
メモリ帯域幅 |
21.6 PB/s |
129.6 PB/s |
6 倍 |
|
ファブリック帯域幅 |
26.7 PB/s |
160.5 PB/s |
6 倍 |
|
I/O帯域幅 |
1.2 Tbit/s |
7.2 Tbit/s |
6 倍 |
WSEの90万個の疎線形代数演算コアは、多くのニューラルネットワーク向けに最適化されています。
各コアはそれぞれ独立して柔軟にプログラム可能であるため、トレンドに合わせてどんなアルゴリズムでも実行することができます。
WSE上のすべてのコアは、シリコン上のSwarmと呼ばれる2次元メッシュ構造の通信ファブリックで相互に接続されています。
シリコン上での通信は、GPU同士間の通信と比べて非常に小さなレイテンシと消費電力で高速通信することが可能です。
WSEはオンチップSRAMを大量実装しており、モノリシックなシリコンチップ上でPB/sクラスのトータルメモリバンド幅でアクセス可能です。
シリコンチップ上の各コアにローカルSRAMを分散配置することで、より低レイテンシで低消費電力を実現しながら高速で柔軟な演算処理が可能になります。
すべてのモデルの重みを外部に保存し、オフチップメモリに関連する従来のペナルティを受けることなく、クラスタの各ノードにストリームすることを可能にする実行モード。ウェイトストリーミングでは、単純なスケーリングモデルで現在の最先端よりも2桁大きなモデルの学習が可能です。
ウェイトストリーミングで利用される外部メモリシステム。MemoryX技術を使用し、すべてのモデルの重みを「オフチップ」で保存し、必要なときにこれらの重みをCSシステムにストリームします。重みがCSシステムを通過すると、WSEは基礎となるデータフロー機構を使って計算を実行し、勾配をMemoryXに戻して重みが更新されるようにストリームバックします。
MemoryXとCSクラスタをつなぐ革新的なブロードキャスト/リデュースファブリック。ハードウェアベースのレプリケーションを使用して、すべてのCSシステムに重みをブロードキャストし、CSシステムからMemoryXに戻される際に勾配を低減します。SwarmXは単なるインターコネクトではなく、データパラレルスケールアウトに特化した学習プロセスのアクティブコンポーネントです。
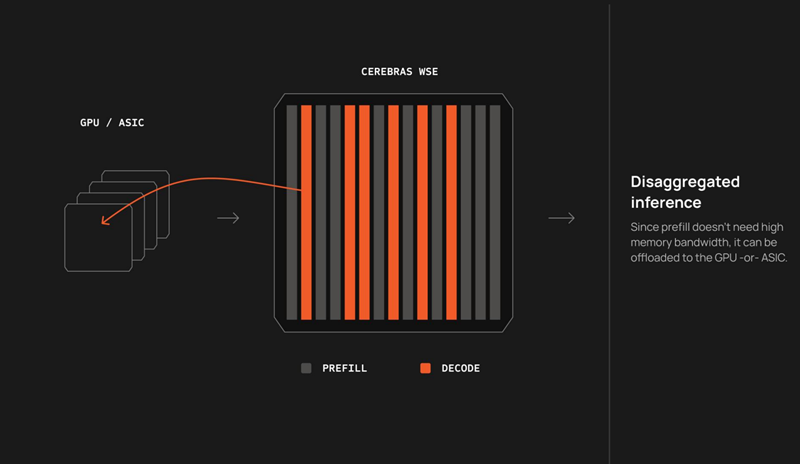
CSシステムは分散推論をネイティブにサポートし、異種混在型AIインフラストラクチャソリューションとして機能します。この分散推論は、他のGPUまたはASICインフラストラクチャを使用して効率的なプリフィルを行いながら、CSシステムを使用して超高速デコードを実行することで、高速推論の提供が可能になります。
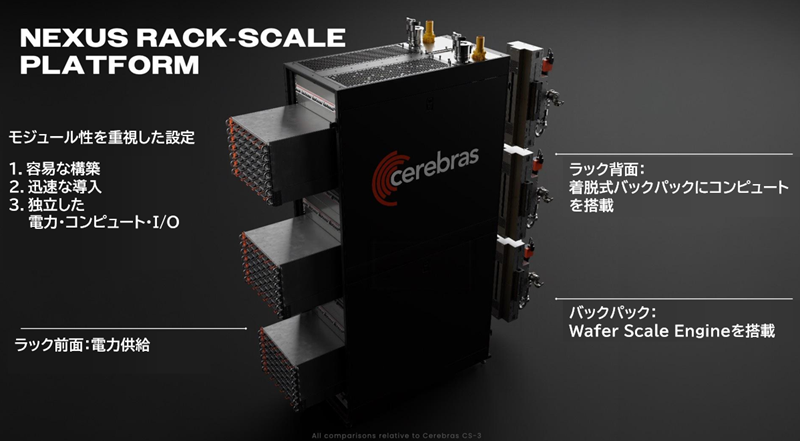
Cerebras Nexusラックスケールプラットフォームアーキテクチャは、コンピューティング、電源、I/Oをモジュール式の要素に分離し、それぞれ独立して拡張・進化させることができます。これにより、イノベーションの加速、迅速な導入とアップグレードが可能になり、ハイパースケールデータセンター全体でCS-4システムの製造、設置、保守をより容易に行うことができます。
従来のGPUシステムよりも最大30倍高速な推論機能を即座に利用可能なAPIアクセスベースのクラウドサービスです。この高速推論サービスにより、コーディング、研究、音声、自動化、その他のエージェント型ユースケースにおいて、よりインタラクティブでインテリジェントな製品を構築できます。開発環境ではDeveloper Tier、実運用環境ではEnterprise Tierを利用することが可能です。
カスタムAIモデルの学習、ファインチューニング、デプロイを行う上で、最も高速かつ簡単にスケーラブルなソリューションです。10億から数十兆ものパラメータを持つあらゆる規模のモデルを、同じシンプルなコードでトレーニングおよび微調整できます。シャーディングも、モデルの並列処理も、コードの書き換えも不要です。Cerebras Training Cloudはシームレスに拡張できるため、インフラストラクチャではなくAIモデルの開発に集中できます。
