自社AIアプリの安全対策は十分か? Prompt Securityによる本番環境の守り方
自社AIアプリを安全に本番運用するために必要なセキュリティ対策と、Prompt for Homegrown Applicationsの活用方法を紹介します。
AIアプリの本番化で見落とされやすいセキュリティ課題
自社の業務データを検索できるチャットボット、社内ナレッジを参照するRAG、問い合わせ対応を自動化するAIエージェントなど、生成AIを組み込んだアプリケーションは急速に実用段階へ進んでいます。
一方、本番化の判断では、モデルの回答精度やレスポンス速度、プロンプト設計に注目が集まりやすく、セキュリティが「モデルの外側」に残されることがあります。
一般的なWebアプリケーションでは、入力検証、認証・認可、通信制御、ログ管理などを複数のレイヤーで実装します。AIアプリケーションでも考え方は同じです。ただし、生成AIでは自然言語が命令とデータの両方として扱われるため、従来の文字列検査やWAFだけでは判断しにくいリスクが加わります。
さらに、AIアプリの動作は利用者の入力だけで決まりません。RAGが取得した文書、Webサイトの内容、外部APIの応答、ベクトルデータベース内の情報、連携ツールから返されたデータなどもモデルのコンテキストになります。
つまり、守るべき対象はチャット画面だけではなく、入力、出力、外部データ、接続先、利用状況を含む処理全体です。
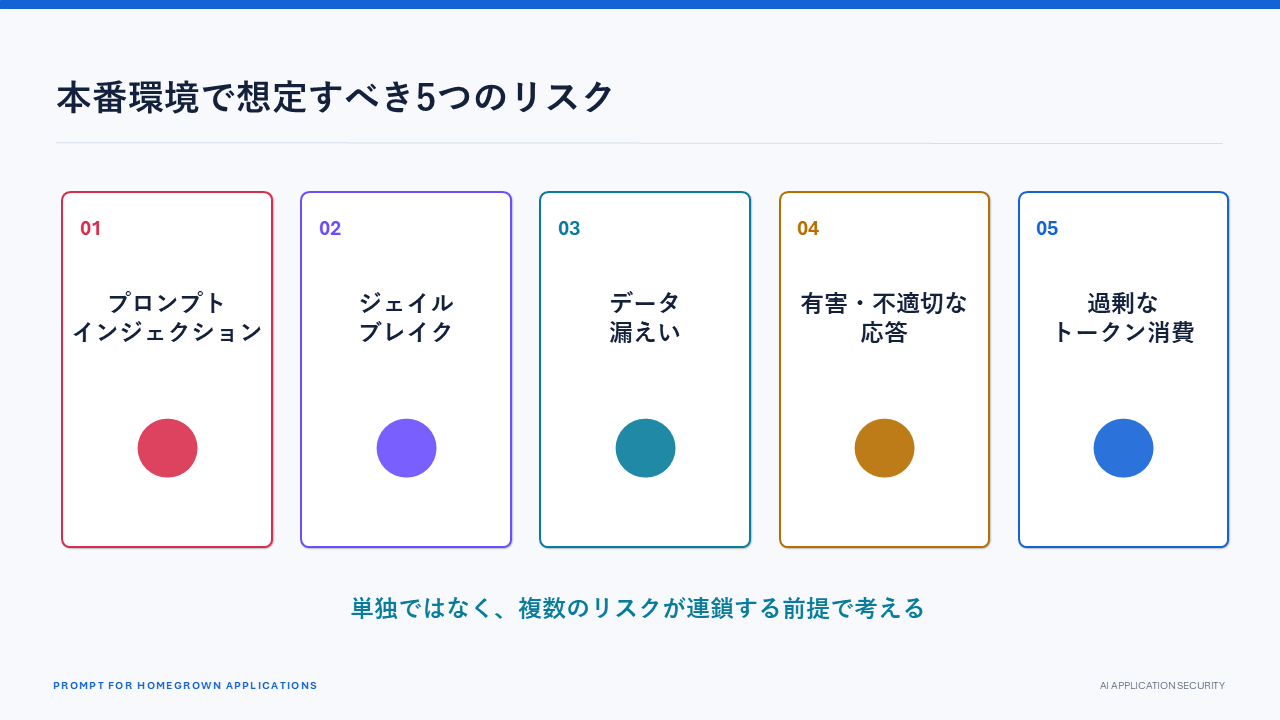
本番環境で想定すべき5つのリスク
1. プロンプトインジェクション
プロンプトインジェクションは、利用者や外部データに含まれる指示によって、AIアプリが開発者の意図とは異なる動作へ誘導されるリスクです。
攻撃者が直接入力する場合だけでなく、RAGが参照した文書やWebコンテンツに不正な指示が埋め込まれている場合もあります。
2. ジェイルブレイク
ジェイルブレイクは、モデルやアプリに設定された安全上の制約を回避し、不適切な情報や本来許可されていない応答を引き出そうとする試みです。
システムプロンプトだけで防御しようとすると、表現の変化や文脈の組み合わせに追従しにくくなります。
3. データ漏えい
入力された顧客情報、個人情報、社内文書、ソースコード、認証情報などが外部LLMへそのまま送信される可能性があります。
反対に、モデルやRAGが保持・参照する機密情報が、回答として利用者へ返される経路にも注意が必要です。
4. 有害・不適切な応答
モデルが攻撃的、不正確、または企業のブランドポリシーにそぐわない内容を生成する可能性があります。
モデル側の安全機能が有効でも、自社の業種、顧客層、利用目的に応じた基準を別途定義する必要があります。
5. 過剰なトークン消費
長大な入力、繰り返し呼び出し、意図しないループなどにより、API利用量やトークン消費が増えることがあります。
これはコストだけでなく、レスポンス遅延やサービス継続性にも関わる問題です。異常な利用によってサービス停止や過剰なコストが発生する「Denial of Wallet/Service」のリスクも考慮する必要があります。
Prompt Securityによる自社AIアプリの保護
Prompt Securityでは、自社開発のAIアプリケーションを保護する「Prompt for Homegrown Applications」を提供しています。
これはモデルそのものを置き換えるものではなく、自社AIアプリケーションとLLMなどの間にセキュリティレイヤーを設け、AIへの入力とAIからの出力を監視・制御するためのソリューションです。
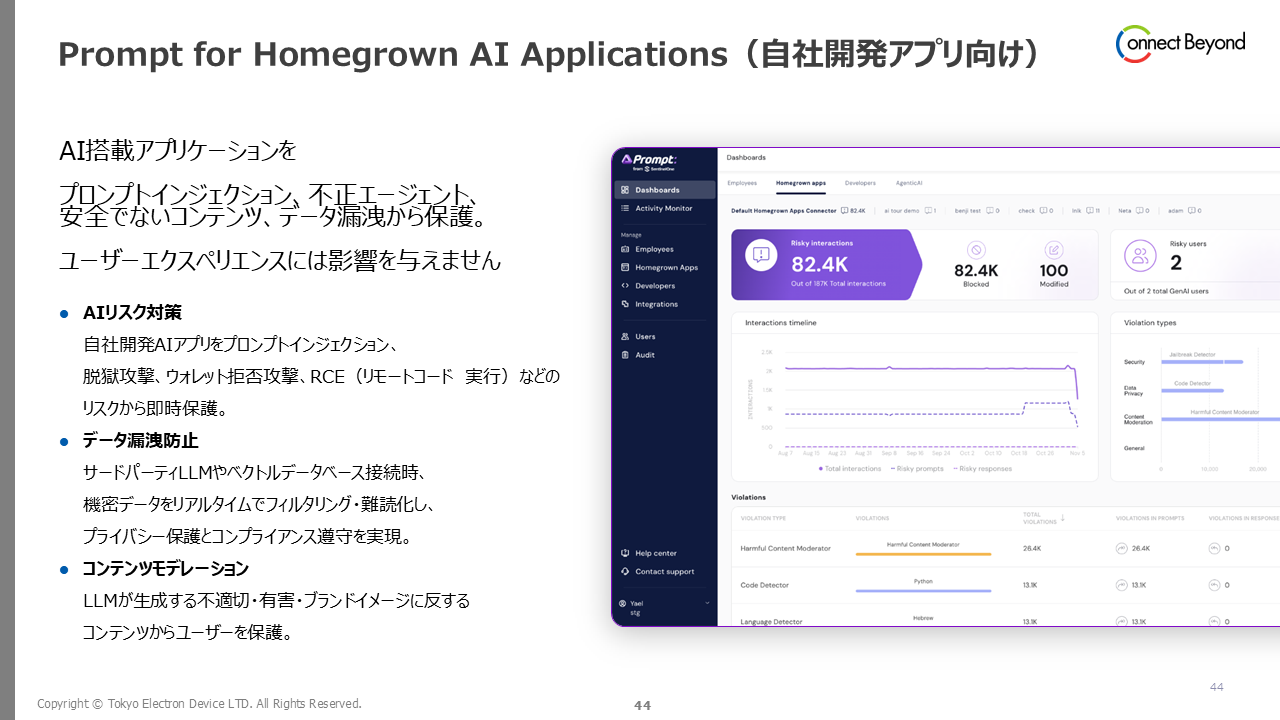
プロンプトとレスポンスの監視・制御
AIアプリケーションの通信経路にセキュリティレイヤーを組み込むことで、LLMへ送信されるプロンプトと、LLMから返されるレスポンスを監視・制御します。
検査結果に応じて、通信を許可する、記録する、ブロックする、または機密情報を加工して処理を継続するといったポリシーの適用を検討できます。
これにより、アプリケーションコードやモデルごとに個別の対策を実装する負担を抑えながら、AIの入出力に対する共通のガードレールを設けられます。
個人情報・機密データの検知と匿名化・マスキング
AIアプリには、氏名、連絡先、顧客情報、社内文書、認証情報、ソースコードなど、さまざまな機密データが入力される可能性があります。
AIへ送信される情報に含まれる個人情報や機密データを検知し、ポリシーに応じて匿名化またはマスキングする構成を検討できます。
すべての処理を一律に停止するのではなく、保護対象となるデータを加工したうえでAIの利用を継続できれば、セキュリティと利便性の両立につながります。
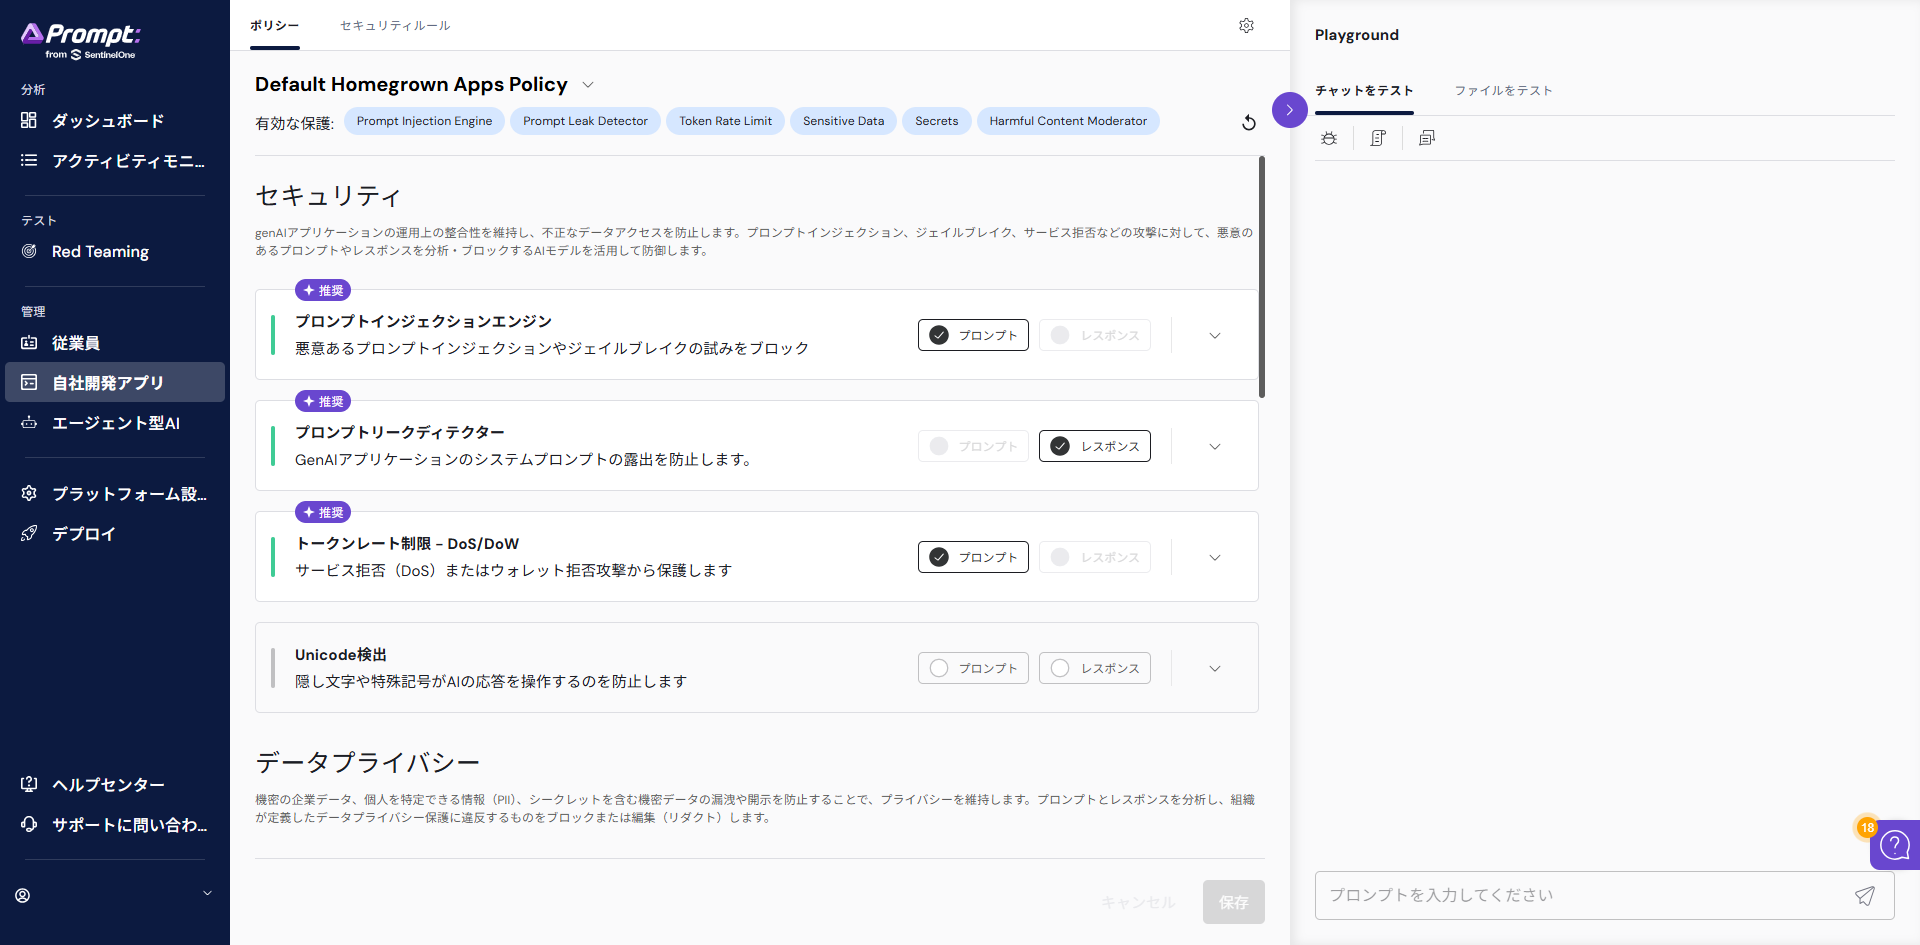
プロンプトインジェクションとジェイルブレイクの検知
プロンプトインジェクションやジェイルブレイクは、単純な禁止語だけで判断することが難しく、表現や文脈を変えながら試行される可能性があります。
AIアプリへの入力を検査することで、モデルの制約を回避しようとする入力や、本来の目的とは異なる動作へ誘導する入力を検知・制御します。
有害・不適切・ブランドにそぐわない応答の制御
入力が安全でも、LLMから常に適切な回答が返るとは限りません。
生成されたレスポンスを検査し、有害、不適切、または企業のブランドポリシーにそぐわないコンテンツが利用者へ表示されるリスクを抑えます。
どのような内容を許可し、どのような内容を制御するかは、AIアプリの用途によって異なります。
顧客向けチャットボット、社内業務支援、FAQ生成、開発支援など、それぞれの利用目的に合わせてコンテンツモデレーションの基準を設計することが重要です。
過剰利用とトークン消費への対策
AIアプリの運用では、プロンプトの安全性だけでなく、APIコール数やトークン消費量も管理する必要があります。
利用者による大量リクエスト、長大なプロンプト、アプリケーションの不具合によるループなどが発生すると、想定を上回るコストやサービスへの負荷につながる可能性があります。
Prompt Securityは、異常な利用や過剰コストにつながるリスクへの対策を提供します。
アプリ別・ユーザー別のルール設定と監査ログ
すべてのAIアプリや利用者へ同じルールを適用すると、業務上必要な処理まで制限してしまう可能性があります。
例えば、一般利用者向けのチャットボットと、社内の開発者向けAIアプリでは、許可するデータやコンテンツの範囲が異なります。
アプリケーションやユーザーなどを対象としてセキュリティルールを設定し、用途に応じてポリシーを分ける構成を検討できます。
また、AIの入力・出力やポリシー違反を記録することで、インシデント調査や監査、ルール改善に活用できます。
Prompt Securityの「Prompt for Homegrown Applications」を活用し、開発・テスト段階のリスク評価と、本番環境における継続的な監視・制御を組み合わせることで、AIアプリの価値を維持しながら、変化するリスクへ対応しやすい運用体制を構築できます。

この記事の投稿者T.S
セキュリティ製品のプリセールスを担当しています。
この記事をシェア